Cuando el mapa genético se equivoca
Imagina que utilizas Google Maps para llegar a un lugar y, de repente, descubres que la carretera por la que estás circulando no aparece en el mapa. El sistema de navegación intenta redirigirte, te advierte de que te has desviado de la ruta y te propone un camino alternativo. Sin embargo, el problema no está en la carretera, sino en que el mapa está incompleto.
Algo parecido puede ocurrir cuando los ordenadores analizan el genoma humano. Comparan la secuencia de ADN de una persona con una secuencia de referencia para identificar diferencias genéticas que podrían afectar a su salud. Sin embargo, si la secuencia de referencia no refleja toda la diversidad natural del ADN humano, una variante genética normal puede parecer un defecto o incluso interpretarse como una mutación potencialmente grave.
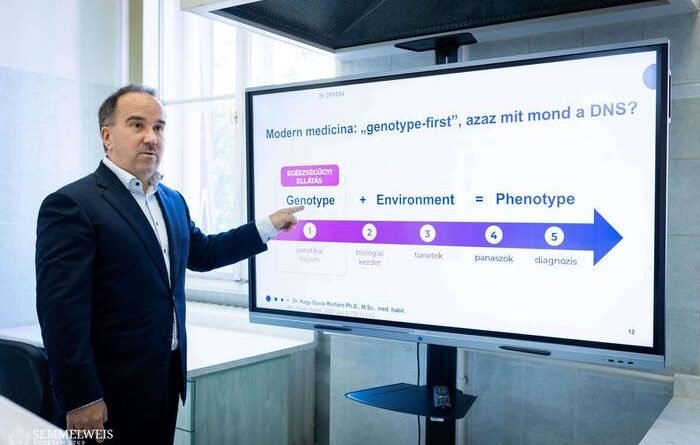
«En la historia natural de una enfermedad con influencia genética, una persona nace con una predisposición genética (genotipo), que puede dar lugar al inicio biológico de la enfermedad, seguido de signos y síntomas observables (el fenotipo) que conducen al diagnóstico. La medicina curativa tradicional sigue un modelo basado en el “fenotipo primero”, es decir, parte de los síntomas del paciente y trabaja hacia atrás para identificar la causa subyacente». Nagy et al., 2026
Un estudio publicado en GeroScience, en el que participan investigadores de la Universidad Semmelweis, llama la atención sobre este problema y plantea interrogantes sobre hasta qué punto podemos confiar en el análisis automatizado del genoma cuando la referencia utilizada para la comparación no representa adecuadamente la diversidad genética humana.
Los resultados se presentaron en el estudio Beyond the linear genome: how reference bias threatens preventive medicine and geroscience. Sus autores son Gyula Richárd Nagy, Gyöngyi Munkácsy, Ankita Murmu, Giuliana Longo, Luis Izquierdo López, Vincenzo Cirigliano y Balázs Győrffy.
El genoma humano contiene aproximadamente tres mil millones de pares de bases. Su código genético está escrito con cuatro nucleótidos: adenina, timina, citosina y guanina. Aunque los seres humanos compartimos casi toda esta secuencia, nuestros genomas presentan diferencias en millones de posiciones. La mayoría de estas diferencias forman parte de la variabilidad genética natural de nuestra especie. Algunas no tienen ningún efecto conocido sobre la salud, mientras que otras pueden influir en el funcionamiento de los genes o modificar el riesgo de desarrollar determinadas enfermedades.
Para identificar estas diferencias, los ordenadores comparan la secuencia de ADN de una persona con un genoma de referencia. Uno de los más utilizados es el GRCh38. Sin embargo, el GRCh38 no representa el genoma humano promedio. Se trata de un ensamblaje de referencia construido a partir de datos genéticos procedentes de distintas fuentes, que no refleja plenamente toda la diversidad genética presente en las poblaciones de todo el mundo.
«El estándar actual, GRCh38, no es un consenso estadístico de la variante de tipo silvestre, sino un ensamblaje en mosaico que contiene alelos minoritarios de referencia (RMAs, por sus siglas en inglés) en loci clínicamente relevantes. Cuando una persona sana presenta el alelo mayoritario común y funcional en un locus en el que el genoma de referencia contiene una variante rara o no funcional, los flujos de trabajo bioinformáticos convencionales —diseñados para detectar diferencias con respecto a la referencia— definen matemáticamente el estado saludable como una variante genética». Nagy et al., 2026
Volvamos a la analogía de Google Maps. Si un mapa muestra solo una de varias rutas posibles, cualquier alternativa puede parecer una desviación. El análisis del genoma puede encontrarse con la misma dificultad. Cuando el ADN de un paciente difiere de la secuencia de referencia, el software puede interpretar esa diferencia como una variante genética. En algunos casos, introduce un hueco artificial para alinear las dos secuencias. Ese hueco puede identificarse erróneamente como una deleción, es decir, una pérdida de ADN que podría señalarse como potencialmente perjudicial. El resultado puede parecer alarmante, incluso cuando el paciente presenta una variante genética normal. En otras palabras, el software puede detectar correctamente la diferencia, pero interpretarla de forma errónea.
Veinte personas sanas, la misma falsa alarma
En el estudio, los investigadores compararon los genomas completos de 20 personas húngaras sanas con la referencia GRCh38. El análisis automatizado señaló el mismo cambio genético como una variante grave en los 20 participantes. Sin embargo, una revisión posterior por parte de expertos determinó que no se trataba de una variante real con relevancia médica.
En la práctica clínica, los hallazgos sospechosos deben someterse a una evaluación adicional antes de considerarse significativos. Este proceso, sin embargo, requiere tiempo y conocimientos especializados. Si la secuenciación del genoma completo se extendiera a millones de personas sanas, la revisión de todos los resultados sospechosos podría convertirse en un importante cuello de botella.
La genómica preventiva tiene como objetivo identificar un mayor riesgo de desarrollar enfermedades antes de que aparezcan los síntomas. Este enfoque solo resulta útil si los resultados son lo suficientemente fiables como para evitar preocupaciones innecesarias y prevenir que los médicos lleguen a conclusiones equivocadas.
«Esta serie de casos observacional incluyó a 20 voluntarios adultos sanos que deseaban someterse a una secuenciación genómica preventiva. Se recogieron aproximadamente 6 ml de sangre de cada participante en tubos de extracción con EDTA. El Centro Nacional Húngaro de Salud Pública y Medicina aprobó el estudio (7177-5/2023/EÜIG) de conformidad con la Declaración de Helsinki. Los participantes otorgaron su consentimiento informado por escrito y no recibieron compensación económica» Nagy et al., 2026
Más allá de un único mapa: una red de rutas posibles
Una posible solución es el pang enoma humano, que representa la diversidad genética de una forma diferente a la de una referencia lineal convencional. Si el GRCh38 es como un mapa que muestra una única ruta principal, un pang enoma se parece más a un mapa que incluye varios caminos posibles entre los mismos puntos. Conecta las regiones compartidas de los genomas humanos con secuencias alternativas presentes en distintos individuos y poblaciones. Este enfoque se conoce como pang enoma basado en grafos. En lugar de obligar a que todas las secuencias de ADN encajen en una única referencia, este método permite que el software siga rutas alternativas que reflejan la variación genética humana real. Si una persona presenta una variante común que no está representada en la referencia convencional, el pang enoma podría permitir que el software la reconociera como una alternativa válida, en lugar de tratarla como una secuencia ausente o alterada.
Esto no significa que el pang enoma vaya a resolver todos los problemas del análisis genético. Sin embargo, podría reducir los errores que surgen en la fase inicial, cuando las secuencias de ADN se alinean con la referencia. Ya existen modelos de pang enoma, pero su uso rutinario en los laboratorios clínicos requerirá una mejor infraestructura informática, procedimientos estandarizados y una validación exhaustiva.
Por qué es importante para la medicina preventiva
Las pruebas genéticas ya se utilizan para diagnosticar enfermedades hereditarias, evaluar el riesgo en familias con predisposiciones genéticas conocidas y orientar el tratamiento de determinados tipos de cáncer. En el futuro, el análisis del genoma podría ayudar a identificar a las personas que se beneficiarían de iniciar antes los programas de cribado o de someterse a un seguimiento más estrecho para detectar ciertas enfermedades. Sin embargo, tener una predisposición genética no significa que una enfermedad vaya a desarrollarse inevitablemente. La salud también está condicionada por la edad, el entorno, el estilo de vida y muchos otros factores. Por tanto, será esencial distinguir los riesgos genéticos reales de los errores introducidos durante el análisis computacional.
«Los estudios futuros deberían centrarse en comparar el rendimiento de los alineadores experimentales de pang enomas con el de estas herramientas de diagnóstico avanzadas. En conclusión, a medida que la medicina avanza hacia el cribado basado en el genotipo como punto de partida, depender de un ensamblaje de referencia lineal entraña el riesgo de ocultar señales clínicas reales bajo el ruido sistemático provocado por el sesgo de referencia. Aunque la transición hacia referencias de pang enomas basadas en grafos constituye una vía muy prometedora para el campo, su implementación rutinaria todavía se enfrenta a importantes obstáculos prácticos. Entre ellos se encuentran la necesidad de mejorar la infraestructura informática, estandarizar los procedimientos bioinformáticos y llevar a cabo una validación regulatoria rigurosa antes de su adopción clínica». Nagy et al., 2026
También existe un posible problema en el sentido contrario. En determinadas circunstancias, una variante realmente perjudicial podría pasar inadvertida si coincide con una secuencia considerada estándar en el genoma de referencia. Los investigadores señalan esta posibilidad, pero subrayan que se necesitan más estudios para determinar con qué frecuencia se produce realmente esta situación.
El estudio tiene sus limitaciones. Solo incluyó a 20 personas de ascendencia europea, por lo que sus resultados no permiten establecer con qué frecuencia se producen errores similares en otras poblaciones. Tampoco demuestran que todos los sistemas de análisis computacional vayan a producir los mismos resultados.
Aun así, la idea fundamental está clara: un análisis genético fiable no depende únicamente de leer correctamente el ADN, sino también de disponer de una referencia que refleje la diversidad de las personas a las que se realizan las pruebas. Un buen sistema de navegación no debería interpretar cada carretera desconocida como un giro equivocado. El análisis genético debería seguir el mismo principio: una diferencia con respecto a la referencia no constituye, por sí sola, una prueba de enfermedad.
Imagen: el Dr. Gyula Richárd Nagy, genetista clínico y profesor asociado del Departamento de Obstetricia y Ginecología de la Universidad Semmelweis, en Budapest (Hungría).
Crédito de la imagen: Boglárka Zellei – Universidad Semmelweis, Budapest, Hungría.
